前阵子帮财务同事处理数电票。原来的流程是把每张发票 PDF 丢给云厂商的识别接口,按次计费,一张几分钱看着不多,一年下来也是一笔钱。我一直以为发票识别属于“必须上模型”的活,直到把几张票拆开看。
先弄清楚数据长什么样
数电票的 PDF 是从开票系统直接生成的矢量文件,文字就在文本层里,跟扫描件不是一回事。我拿一百多张真实的票跑了一遍,每张的文本层有三百到七百个字符,发票号码、开票日期、购销方名称和税号、明细行、税率、价税合计、开票人全都在。页面上那几张图只是电子签章,尺寸一百来像素,不是整页扫描。
所以这批票一张都不需要 OCR。判断很简单,用 PyMuPDF 打开取一次文本,字符数是零或者只有几个,才是真的需要识别。
取字段靠坐标,不靠模型
文本层给的是按阅读顺序排的一串字:先是所有栏目标签,再是所有值。光按顺序取会错位,得用带坐标的词。
做法是把页面上的词按坐标还原:同一水平位置聚成一行,表头那一行推出每一列的横向边界,数据行按中心点落进最近的列。购销方靠左右半页划分,发票号码和开票日期找标签右侧的词。这套规则不写死任何尺寸,换一种版式也能用,代价是每种新式样都要拿真票验一遍。
光取出来还不够,得能判断取得对不对。我加了四条自校验:
- 价税合计等于金额加税额
- 大写金额换算成数字后等于小写
- 明细行金额之和等于合计金额
- 发票号码是八到二十位数字,税号是十五到二十位大写字母数字
四条里有任何一条不成立,就把这张票拦下来,不写入。宁可人工看一眼,也不让错数进库。实际跑下来,一百零三张票全部通过,其中十七张同时有官方 XML 的,逐字段比对下来零差异。
换到浏览器里跑,踩了几个坑
桌面版不想让财务装 Python,所以把解析挪到了浏览器,用 pdf.js。同样一份规则翻成 JavaScript,结果一开始只过了一半。
pdf.js 的取词和 PyMuPDF 有差别。一是数字会被拆成重叠的碎片,比如 132 和一个 .30,两个词的横向范围还叠在一起;二是表头会被逐字拆开,单 位、金 额 各是两个词;三是部分票的字体要靠 CMap 才能映射回汉字,不带 CMap 资源时有张票整段取不到,只剩几个字段。
处理办法:相邻且重叠的数字碎片先拼回去,但要限定只向右拼、拼完还得是一个合法数字,否则会把相邻两列的数粘成一个;表头被拆开的字按“拼起来像不像表头”合并;CMap 和标准字体随程序一起打包,共三兆多。
还有一个坑跟解析无关:浏览器会缓存 js 文件。改完界面在本地看着没变化,查了半天才发现加载的是旧脚本。后来给页面和静态资源都加了 no-store,升级后打开就是新的。
做成桌面小程序
选 Go 写单文件程序,不用 CGO,编译出来十五兆,里面嵌着前端页面和 pdf.js。数据库用 sqlite,一个文件,备份就是拷走 data 目录。
程序启动后只监听本机,带一个随机令牌,然后用系统默认浏览器打开界面,不需要额外装运行时。关掉页面一分半没有心跳就自己退出,不会在财务电脑上留后台进程。
导入走 Windows 的原生文件夹选择框。这里绕开了一个浏览器行为:网页里的“选文件夹”控件在 Chromium 上每次都会弹“是否将 N 个文件上传到此站点”,关不掉。让程序自己去读目录、把解析结果提交给本地服务,这个框就不会出现。顺带也不需要把文件字节搬来搬去。
界面部分有几处是实际用起来才发现的:
- 端口不能随机,因为浏览器按“协议+主机+端口”隔离本地存储,端口一变,用户调好的列宽和筛选条件全丢。改成固定端口,被占用时才退回随机。
- 列宽要能跟着窗口走,还要能手动拖。纯按像素排,窗口一窄就把“销售方”挤成竖排字;纯按百分比,用户拖过的列又会被摊回去。最后做成拖动过的列固定像素,其余列按权重分剩余宽度,装不下就横向滚动。
- 税率一开始显示成 0.06 和 6% 混着来。原因是两条来源口径不同:PDF 票面印的是百分比,官方 XML 里存的是小数。入库和显示都统一成票面写法。
现在的样子
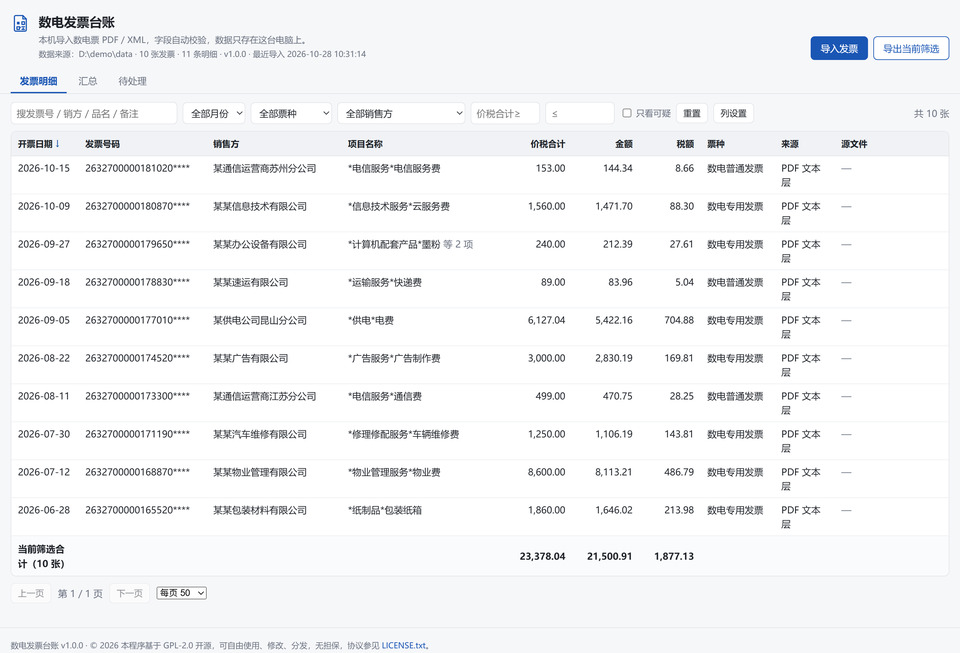
导入一个文件夹,自动识别、校验、入库;列表可以自选列、拖宽、按月份票种销方筛选;汇总按账期和销方统计;导出带 BOM 的 CSV,Excel 直接打开。图片型 PDF 和多页文件归到“待处理”,不猜数字,等人工补录。
程序不保存原件副本,只记录导入时的来源路径,点一下用系统默认程序打开。这样目录不会越滚越大,但原始文件夹就不能随手挪了。
代码放在 gitee.com/xuuz/einvoice-ledger,GPL-2.0。里面打包的 pdf.js 是 Apache-2.0,许可证文本跟着仓库一起放。
一点想法
这个需求第一眼看过去很像“该上 OCR 了”,实际把数据摸清楚之后,九成以上的工作量在版式还原和一致性校验,跟模型没关系。以后遇到类似的票据、报表、对账单,我大概都会先问一句:这个 PDF 的文本层是空的吗。