这篇记录一次”提前换盘”的全过程。盘没有彻底坏,但已经在带伤硬撑,我选择在它崩掉之前挑个晚上把活干完。
报警来得比想象中快
那是一台 2011 年的 2U 服务器,跑 Oracle 老业务库,RAID5 三块 300GB 的 10K SAS 盘。之前这台机器没有任何盘级监控,坏了才知道。上个月给它补了一套巡检:定时读阵列卡上的物理盘状态,再通过 smartctl 取每块盘的 SMART 明细,三分钟一次。
部署完第二天,两条告警同时亮了:一块盘的”增长缺陷表”超过阈值,以及盘的健康状态不是 OK。
增长缺陷表(grown defect list)是盘内部的一本账:读写时发现坏块、把它重映射到备用扇区,就会在这里记一笔。数字大说明坏块多、备用区在消耗。另一条”健康非 OK”来自盘自己的预测失败判定,意思是厂商认为这块盘该换了,不是”已经读不出来”,但也不再是”可以慢慢拖”。
后来我还补了一层阵列级监控:逻辑盘的状态(Optimal / Degraded / Failed)和重建进度。盘级 SMART 只能告诉你”某块盘不太好”,阵列级才能回答”现在还有没有冗余”。这次换盘当晚,重建百分比就是从这层看的。
先看数据再决定急不急
把三块盘的数据拉出来放在一起,结论很清楚:
| 指标 | 槽位 0(原装盘) | 槽位 1 | 槽位 2 |
|---|---|---|---|
| 增长缺陷表 | 8191(已到字段记录上限) | 0 | 0 |
| 不可纠正错误 | 23 | 0 | 0 |
| 非介质错误 | 296 | 0 | 0 |
| 卡侧预测失败计数 | 20(七天 +7) | 0 | 0 |
| 通电时长 | 约 14.7 年 | 约 1.1 年 | 约 2.9 年 |
| SMART 判定 | FAILED | OK | OK |
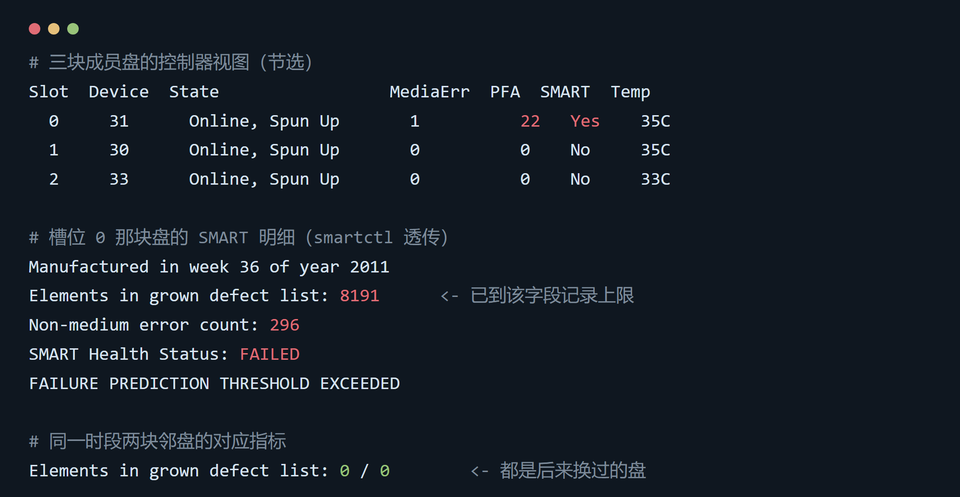
8191 不是巧合,是这块盘该字段的记录上限,也就是说它已经”记满了”。另外两块盘都是历史上换过的,通电才一两年,指标全零。同一台机器、同一个控制器、同样的负载,只有那块随机器出厂的原装盘倒下,横向对比比任何单点数据都有说服力。
预测失败计数七天涨了 7 次,一直在恶化。这个数字后来还涨到过 22,说明它确实在持续变差。
为什么不等它自己坏
RAID5 只容错一块盘。它真坏了,阵列降级,业务还能跑,但紧接着要开始重建:把剩下两块盘全盘读一遍、重算校验、写到新盘上。重建期间阵列没有任何冗余,这时候只要另一块盘出现一个读不出来的坏块,整个阵列就报废了。
老机械盘上存在不可纠正读错的概率,数值很低,但重建恰好是把所有扇区都读一遍的时刻,潜伏的坏块最容易在这时浮现。换句话说,等它坏,等于把风险押在”重建那几个小时里别出事”上,而且这个窗口往往出现在半夜,人还不在现场。
所以这次的选择是:趁另外两块盘全零健康、备件在手、时间可选,主动把窗口拿在自己手里。
方案:热备替换法
常见的做法是”先拔旧盘、再插新盘”,缺点是拔下来的那一刻阵列就降级,等新盘插上才开始重建,中间这段完全靠人工,时间不可控。
这次用的是另一种顺序:新盘先插进空闲槽、在卡上设成全局热备,然后强制离线旧盘。卡发现阵列少了一个成员、又有可用的热备盘,会立刻自动开始重建,全程不用人工插拔参与。旧盘一直留在槽里,直到重建成功、验证通过之后才拔。
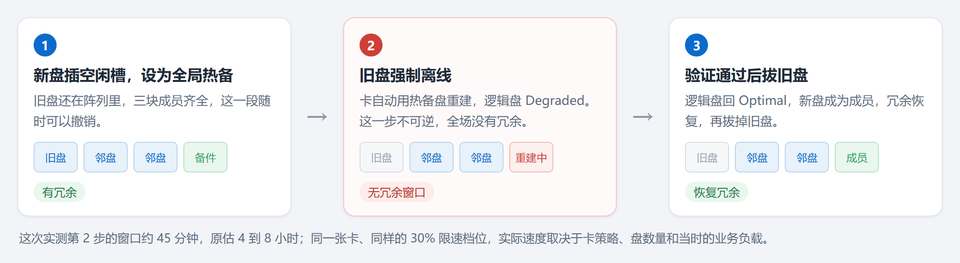
具体命令如下,槽位号按实际环境改:
# 1. 新盘设成全局热备(Enclosure 252 / Slot 3 是物理位置)
MegaCli -PDHSP -Set -PhysDrv[252:3] -a0

# 2. 回读确认,应该看到 Hotspare, Spun Up
MegaCli -PDList -aAll | grep -A6 "Slot Number: 3"

# 3. 强制离线旧盘,这一步不可逆,卡从这里开始往新盘写
MegaCli -PDOffline -PhysDrv[252:0] -a0

# 4. 看重建进度
MegaCli -PDRbld -ShowProg -PhysDrv[252:3] -a0

# 5. 完成后验证:逻辑盘回 Optimal、新盘变成成员
MegaCli -LDInfo -Lall -aAll
顺带说一句缓存。这块卡没有电池,写策略一直是 WriteThrough(直写),重建期间就算掉电也不会丢缓存,代价是写性能低一些。如果卡带电池并开着 write-back,动手前要确认电池或电容的状态;电池失效时卡通常会把缓存降级成直写,性能和预期都会变,别在没注意这一点的情况下排一个长时间的重建。
有两个编号容易搞混:命令里用的是”Enclosure + Slot”的物理位置,而工具输出里还会有一个 Device Id,是控制器视角的编号。两者不是一回事,动手前先用 -PDList 把两列对照核一遍,插错槽位的代价很高。
另外,强制离线之后旧盘会显示成 Unconfigured(good),不是 Offline。这是正常的,卡把踢出阵列的盘退回未配置状态,别以为命令没生效又去补一条。
动手那一晚
开工前做了三项检查:确认当天有一份完整的数据库导出并且已经落到备份机、再取一次物理盘列表确认两块邻盘的介质错误是零、看一眼业务 IO 确实处于低谷(当时 iowait 不到 1%)。三项都过了才动手。
时间线很短:
| 时间 | 动作 | 结果 |
|---|---|---|
| 20:03 | 新盘设热备 | Success,回读 Hotspare |
| 20:04 | 旧盘强制离线 | 15 秒后新盘进入 Rebuild,逻辑盘 Degraded,0% 自动开始 |
| 20:30 | 自动采集 | 60% |
| 20:49 | 完成 | 逻辑盘 Optimal,三块成员齐 |
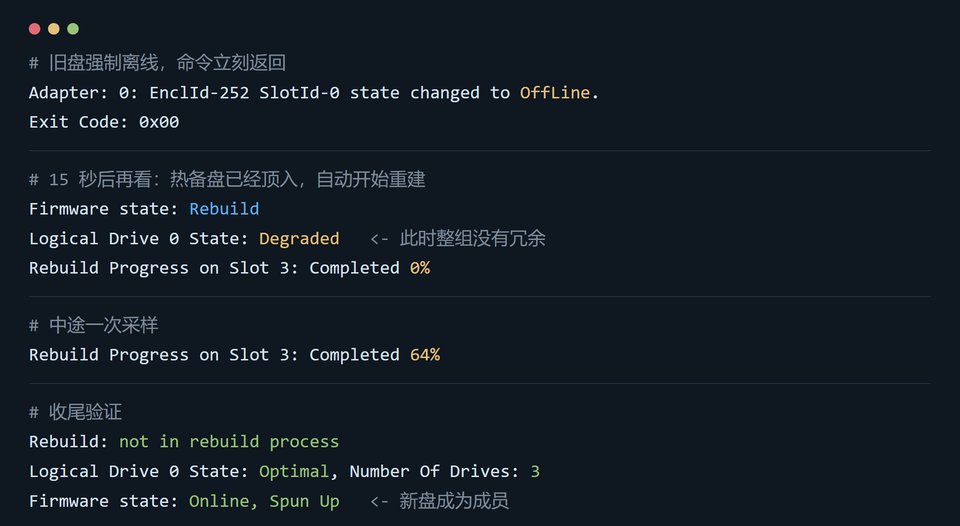
全程约 45 分钟,比我预估的 4 到 8 小时短了一个数量级。同一个 30% 的重建限速档位,能差这么多,说明真正的瓶颈在卡自己的策略、盘的数量和当时的业务负载,而不是那个百分比。以后再估同类操作,我会保守,但不会因为估得久就不敢排窗口。
重建期间盯的是最容易出事的两处:两块邻盘的介质错误和预测失败计数,自始至终是 0;新盘的介质错误、预测失败、增长缺陷也全是 0。峰值温度分别是 42℃、40℃、34℃,重建结束后回落。业务侧没有中断,只有性能略微下降。
几个事后才想明白的点
第一,重建期就是无冗余期。 我最初在方案里写过”这个方法没有冗余空窗”,是错的。热备替换法省掉的是人工插拔那几分钟,重建那几个小时阵列照样是 Degraded、照样没有冗余。这句话写进方案时如果含糊,后面所有风险评估都会跟着错。
第二,不可逆的点在”离线”,不在”拔盘”。 我原来以为最坏情况还能把旧盘重新拉回阵列。实际上离线之后卡已经开始往新盘写数据,强行把旧盘上线并不保证被干净接受,能不能无损撤回要看卡的具体行为。真正的决策点在离线那一刻,按下去之前要想清楚。
第三,业务没停不等于数据安全。 逻辑盘在重建期一直在线,用户照常访问,但这跟”万一第二块盘坏了数据还在”是两件事。能救数据的只有备份,而且备份得真的能恢复,没做过恢复验证的备份只能算”文件存在”。
第四,旧盘不拔,告警不会自己消失。 盘还在槽里,SMART 照样能读,触发规则的表达式仍然为真,把告警手工关掉它会立刻重新开出来。正确顺序是先拔盘,让监控的自动发现把这块盘的对象移除,然后再关闭事件。
第五,备件要当二手盘对待。 买的是同级别的库存盘,生产周次比这台机器晚不了几年,SMART 全绿也只能说明它现在能用。装上之后我把它纳入了常规巡检,看增长缺陷和预测失败计数,不把它当”新盘”。
第六,留痕比记性可靠。 每条命令带时间戳写进日志文件,另外加了一个每 30 分钟跑一次的只读采集,把进度、计数、温度都记下来。换盘当晚只有一两个小时需要盯着,剩下大半靠这些记录,事后复盘和写这篇文章也都靠它。
收尾
重建完成后还有三件小事:把新盘的计数记成新基线、几天后现场把旧盘拔掉贴标签留存(它已在阵列之外,支持热插拔,拔的时候业务不用停)、确认监控里旧盘的对象已经消失再把告警关掉。
这次真正值钱的不是换盘本身,而是监控在那块盘”还没坏”的时候把它逮住了,给了从容安排的时间。至于没做好的地方也留一笔:备份的恢复验证这次仍然没做,只验证了备份文件按时生成。这一点不该学,下次排窗口应该把它放进前置条件。